Hace un par de semanas leí en LinkedIn un análisis de Álvaro Peña de Luna, de iSocial, sobre los robots.txt de 35 grandes webs españolas.
El robots.txt es un fichero público, una especie de brújula que orienta a los rastreadores: les dice por dónde pueden ir y por dónde no.
Eso sí: es una brújula, no una puerta.
El rastreador que quiera puede ignorarla.
De las 35 del estudio de Peña de Luna, 27 no dicen nada sobre los bots de IA.
Ni sí ni no.
De las 8 webs que sí dicen algo, 7 de ellas dan paso y una pide que no entren.
Su conclusión era sencilla y cierta: casi nadie ha escrito qué deben hacer los rastreadores.
Quien no decide deja la puerta abierta, porque esa es la opción por defecto.
Y así saltó una pregunta: ¿qué hacen sus servidores cuando llama un bot?
Me pareció una pregunta demasiado buena para dejarla en el fichero.
Lo que dice el robots.txt y lo que hace el servidor
El robots.txt es lo que una web declara. Lo que su servidor hace cuando llama un bot es otra cosa, y nadie lo estaba mirando.
Así que lo miré. No en 35 grandes marcas, sino en 664 webs de un sector concreto, modesto, sin embargo de trascendencia en todo hogar.
Tiendas y estudios que diseñan y venden cocinas, con establecimiento físico en siete comunidades.
Pymes con hosting compartido, WordPress y banner de cookies.
Las webs de verdad.
Antes de los números, lo que este estudio no dice
Una petición con el nombre de GPTBot en el User-Agent no viene de OpenAI. Es una sonda con identificador imitado. Por tanto:
- Un rechazo a mi sonda no demuestra que esa web bloquee al bot auténtico. Demuestra que trata distinto a quien se presenta con ese nombre.
- Que testigo y bots fallen a la vez no es «bloquean a la IA». Es un fallo compartido de causa desconocida, y así lo cuento.
- Permitir el rastreo no garantiza que un agente te cite. Y prohibirlo en robots.txt no impide que el servidor entregue la página: robots.txt no es un control de acceso.
- Un código 200 no acredita contenido útil. Puede ser un desafío, una página vacía o una plantilla sin texto.
Todo lo que sigue se lee con esas cuatro reglas puestas.
Cómo lo medí
Para cada web fijé dos URL, la portada y una página interior elegida por una regla reproducible, y descargué su robots.txt.
A cada URL le pedí lo mismo diez veces, cambiando solo el User-Agent:
- Un navegador como testigo
- Siete bots de rastreo e inteligencia artificial (GPTBot, ClaudeBot, PerplexityBot, Googlebot, bingbot, CCBot y Bytespider)
- En una segunda tanda, los dos bots de búsqueda que citan en lugar de entrenar: OAI-SearchBot y Claude-SearchBot
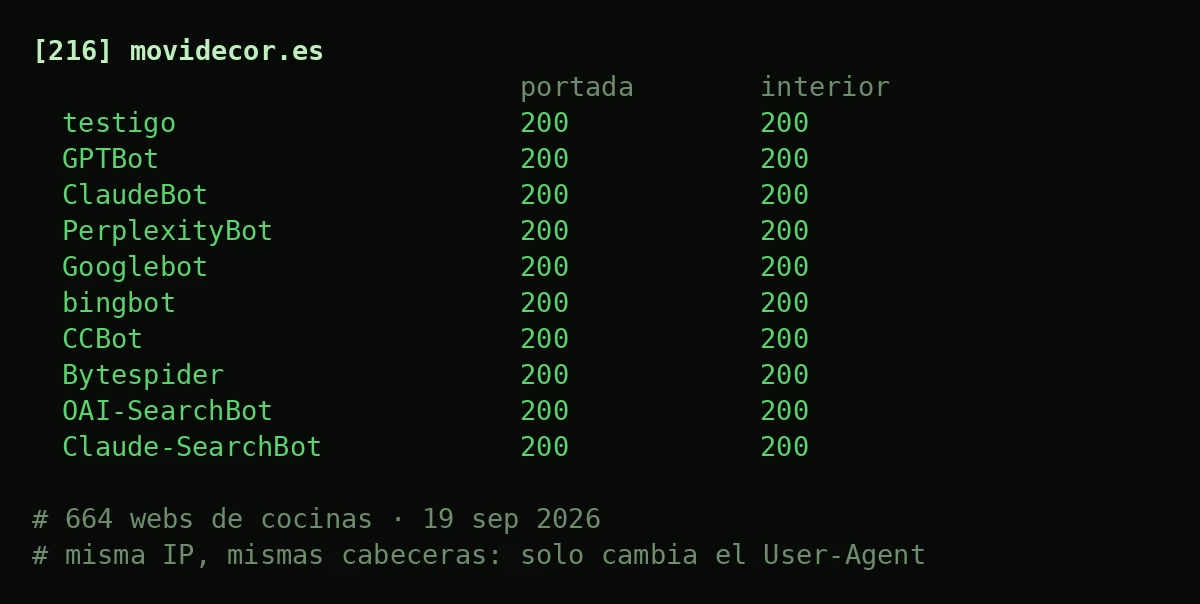
Misma IP, mismo cliente, mismas cabeceras, sin cookies, una petición cada dos segundos por dominio.
Toda discrepancia entre el testigo y un bot se repitió al menos diez minutos después; solo cuentan las que se repitieron.
Y para descartar que el resultado dependiera de la IP de un centro de datos, la muestra de control se lanzó también desde una conexión doméstica: en 1.000 peticiones, los rechazos por identificador fueron los mismos desde los dos sitios.
Lectura de cada robots.txt: reglas, no nombres
Sobre robots.txt no busqué nombres: apliqué las reglas efectivas de cada bot sobre cada URL, con las precedencias del estándar.
Un bot puede no aparecer y estar restringido por el grupo general, o aparecer y no significar nada porque está pegado a otro grupo sin regla en medio.
También lo tuve en cuenta.
En total, más de 20.000 peticiones a 664 dominios, dos tandas de repetición y una muestra renderizada con navegador para comprobar que el contenido no se escondía tras JavaScript.
No se esconde: en 40 dominios al azar, ninguno depende de él.
Lo declarado en robots.txt: el 96 por ciento no ha escrito nada sobre bots de IA
De 630 robots.txt con contenido:
- 27 nombran a algún bot de inteligencia artificial.
- GPTBot aparece en 15 ficheros: 6 lo restringen y 9 lo permiten expresamente.
- Los bots de búsqueda casi no existen: OAI-SearchBot está en 4 ficheros, siempre permitido, y Claude-SearchBot en ninguno.
- El único nombre que este sector restringe de verdad por escrito es meta-externalagent, el rastreador de Meta, con Disallow en 13 ficheros.
- Googlebot es el más nombrado, en 29, casi siempre para permitirlo.
Solo el 4 por ciento de las webs declara algo sobre bots de IA. El resto no ha escrito ni una línea.
Hasta aquí, el mismo paisaje que en las grandes marcas. Casi nadie ha decidido nada.
Ahora la otra mitad.
Lo servido: el 27 por ciento actúa igualmente
178 de los 664 dominios rechazan a algún bot que su robots.txt permite, con el testigo recibiendo la página con normalidad, y en las dos tomas.
Escriben 27, actúan 178.
| Bot | Dominios que lo rechazan pese a permitirlo |
|---|---|
| Bytespider | 135 |
| ClaudeBot | 75 |
| CCBot | 72 |
| GPTBot | 67 |
| PerplexityBot | 17 |
| Googlebot | 5 |
| bingbot | 5 |
La escalera es nítida.
- Bytespider, el rastreador de ByteDance, es el paria: uno de cada cinco sitios lo bloquea.
- Los de entrenamiento de Anthropic, Common Crawl y OpenAI van detrás, a distancia.
- PerplexityBot apenas se toca.
- Googlebot y bingbot pasan casi siempre, como es lógico en webs que viven de aparecer en el buscador.
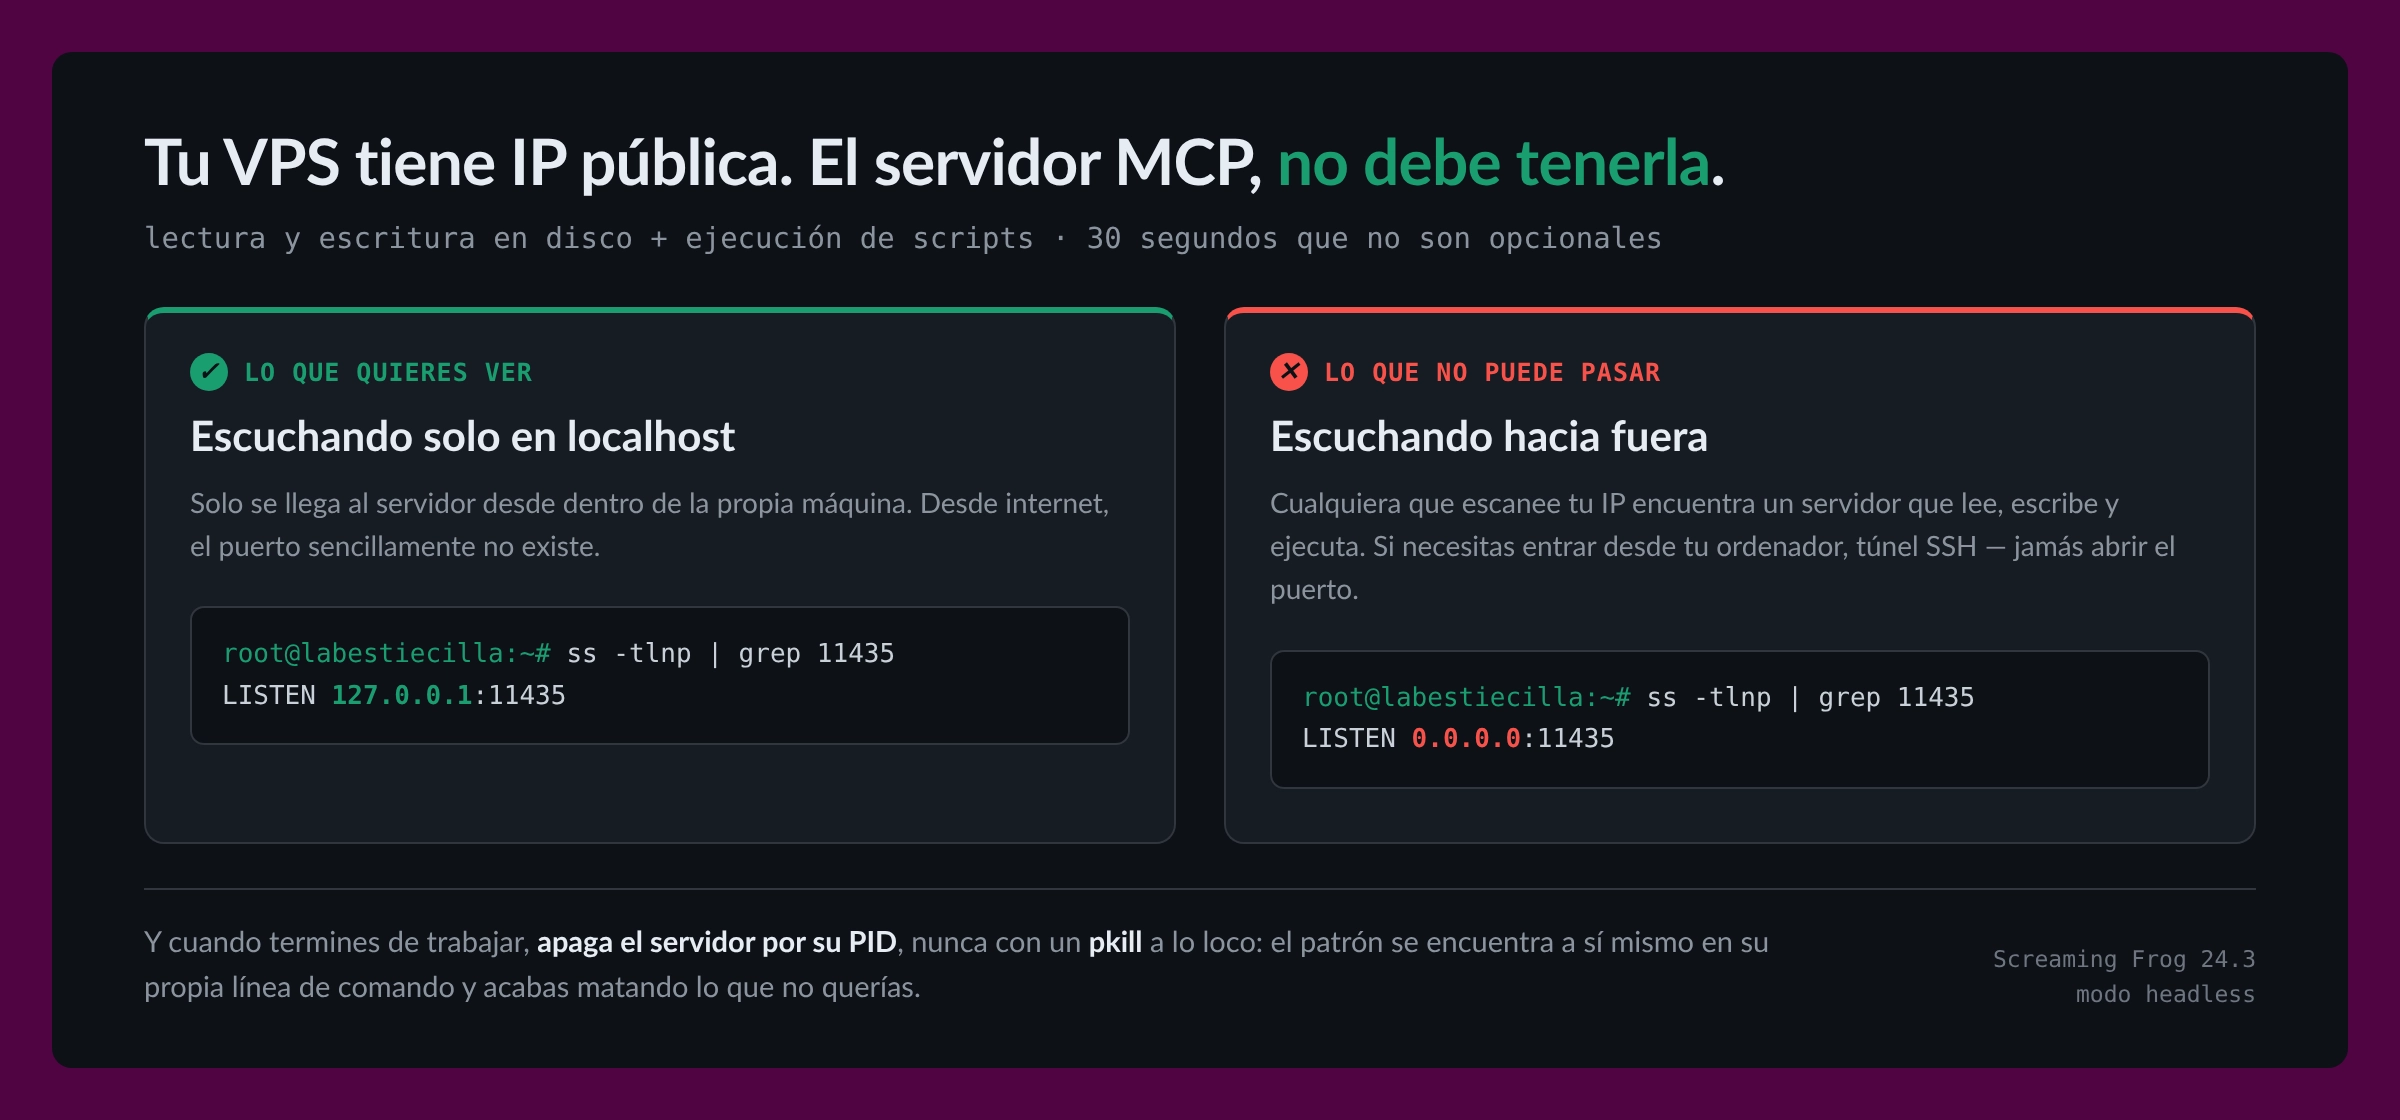
Los rechazos tienen forma: un 403 seco, un 406 de Apache con mod_security, o un 429 que salta en la primera petición y solo a un nombre, que es un límite de tasa con otro disfraz.
Y en la mayoría de los casos, quien responde es Apache, Nginx o LiteSpeed con reglas de fábrica, no un panel de Cloudflare configurado a mano.
En 70 de los 135 rechazos a Bytespider, el servidor es Apache.
Esa es la vuelta de tuerca. En las pymes, la decisión sobre los bots de IA no la ha tomado la marca.
La ha tomado el hosting, y las pymes no lo saben.
Entrenamiento y búsqueda: el sector hace lo que nadie le ha pedido
El post de referencia insistía en una distinción que importa: GPTBot entrena al modelo y afecta a lo que la IA sabe de ti; OAI-SearchBot indexa para ChatGPT y afecta a si te cita.
Bloquear los dos es desaparecer.
El bloqueo del primero es proteger el contenido sin perder visibilidad.
Sondeé los dos pares.
| Par | Rechazan al de entrenamiento | Rechazan al de búsqueda | Solo al de entrenamiento |
|---|---|---|---|
| GPTBot / OAI-SearchBot | 67 | 21 | 49 |
| ClaudeBot / Claude-SearchBot | 75 | 9 | 67 |
179 dominios rechazan a algún bot de entrenamiento (los 178 de antes más uno que corta la conexión al identificador); 21 a alguno de búsqueda.
Sin que casi ninguno lo haya escrito, el sector frena al que entrena y deja pasar al que cita.
Exactamente la decisión que el post pedía tomar por escrito.
Solo que aquí no la tomó nadie: la trae puesta el servidor.
Tres casos, con nombre
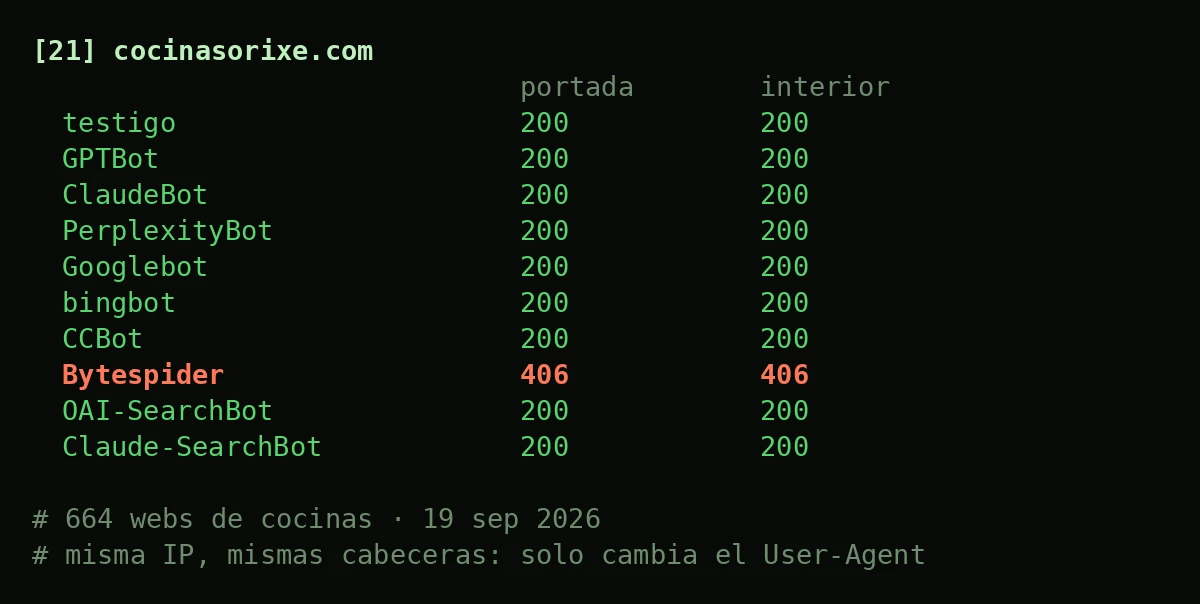
cocinasorixe.com. Su robots.txt no nombra a ningún bot.
Su servidor devuelve un 406 a Bytespider en portada e interior, en las dos tomas y desde las dos IP, y un 200 a todo lo demás.
Es la firma de una regla de servidor contra ese identificador.
Nadie la escribió en el fichero público; alguien la puso en el servidor, o venía de serie.
3bide.com y advanceinteriorismo.com. Permiten todo en robots.txt y devuelven 403 a OAI-SearchBot, el bot que decide si ChatGPT los cita, mientras sirven la página al testigo.
También rechazan a GPTBot y a ClaudeBot. Es lo que el post de referencia llamaba desaparecer: cerrar al que entrena y al que cita.
Son 2 de los 18 dominios que rechazan a los dos bots de OpenAI. Probablemente no lo saben.
baycoestudio.com, suarco.es y tarracogrup.com. El caso inverso. Se parece al de mutua.es en el post original, pero un peldaño más abajo: allí el comentario decía bloqueo y la directiva Allow; aquí la directiva dice Disallow para GPTBot y el servidor le sirve la página igual.
No es una contradicción técnica, porque robots.txt es una petición de cortesía.
Sin embargo, quien lo escribió cree que ha cerrado una puerta que está abierta de par en par.
Comunidades y segmentos: la brecha es la misma en todas partes
| Comunidad | Sitios | Escriben algo | Rechazan a alguno |
|---|---|---|---|
| País Vasco | 70 | 4 (6 %) | 26 (37 %) |
| Andalucía | 190 | 7 (4 %) | 43 (23 %) |
| C. Valenciana | 84 | 5 (6 %) | 24 (29 %) |
| Galicia | 67 | 0 (0 %) | 19 (28 %) |
| Madrid | 99 | 2 (2 %) | 30 (30 %) |
| Cataluña | 75 | 2 (3 %) | 14 (19 %) |
| Castilla y León | 103 | 11 (11 %) | 22 (21 %) |
Galicia es el caso limpio: ningún robots.txt nombra a un bot de IA y 19 de 67 sitios rechazan a alguno.
Castilla y León es la que más escribe y no por eso rechaza más.
Escribir y actuar van por vías distintas.
Por segmento pasa lo mismo: tiendas, estudios de interiorismo y carpinterías rechazan en proporciones parecidas.
El coste de un 403 al bot de búsqueda
Un 403 a OAI-SearchBot no es un dato técnico. Es una ausencia.
Cuando alguien pregunta a ChatGPT por una cocina a medida en su ciudad, esa web difícilmente aparece en la respuesta, porque el bot que la indexa para ChatGPT nunca ha entrado.
Da igual lo que posicione en Google. El buscador del agente no la tiene.
Abrir la puerta no garantiza la cita.
Nadie sabe cómo se consigue que una IA cite a una web concreta, y quien diga que lo sabe vende humo.
Abrir la puerta permite que se dé la posibilidad. Cerrada, la posibilidad desaparece.
21 de las 664 webs de este estudio viven sin esa posibilidad. 18 de ellas se la han quitado con los dos bots de OpenAI a la vez, sin haber escrito una línea.
Qué hacer con esto
El post de referencia terminaba con un ejercicio de dos minutos: abre tu robots.txt, busca GPTBot y OAI-SearchBot y mira qué regla tienen.
Añado dos minutos más, porque el fichero no te dice lo que hace tu servidor.
- Abre tudominio.com/robots.txt. Si no nombra a ningún bot de IA, no has decidido nada por escrito. Sigue siendo así para el 96 por ciento.
- Pide tu portada con el nombre de un bot. Desde una terminal basta una línea:
curl -sI -A "GPTBot" https://tudominio.com/ | head -1
curl -sI -A "OAI-SearchBot" https://tudominio.com/ | head -1- Si el primero devuelve 403 o 406 y el segundo 200, tu hosting ya ha tomado por ti la decisión que el post te pedía tomar. Si los dos devuelven 403, estás desapareciendo de los agentes sin haberlo elegido. Si los dos devuelven 200 y tu robots.txt dice Disallow, la puerta que crees cerrada está abierta.
Si prefieres no abrir una terminal, comprueba qué reciben los rastreadores de IA en tu web con el AI Crawler Checker. Es gratis.
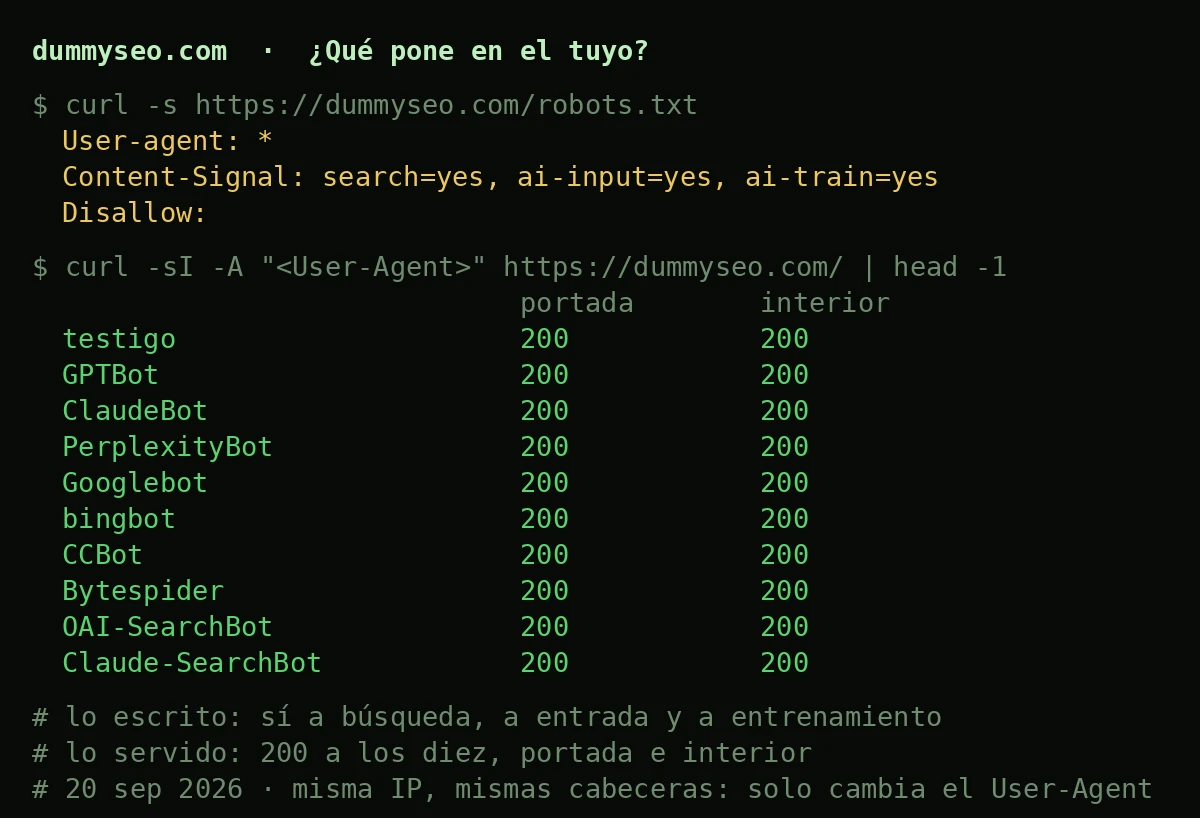
Es mi decisión para dummyseo.com: sí a la búsqueda, a la entrada y al entrenamiento, escrito en el fichero y cumplido por el servidor. Es la que aplica a mi caso. No sé si aplica al tuyo, y nadie lo sabe sin hacer el ejercicio.
Ficha del estudio
Muestra: 664 dominios.
Tiendas y estudios de cocinas con establecimiento físico en:
- País Vasco
- Andalucía
- Comunidad Valenciana
- Galicia
- Madrid
- Cataluña
- Castilla y León
Los 664 dominios se seleccionaron por censo de resultados de búsqueda y validación documental fila a fila, congelada antes de medir.
Medición
Fecha: 19 de septiembre de 2026.
El estudio se hizo con:
- Dos tandas de sondas con repetición de las discrepancias
- Dos controles desde una IP residencial, de 30 y 50 dominios
- Muestra de renderizado con navegador
Los cuerpos de las más de 20.000 respuestas se conservan.
No es un censo del sector ni permite extrapolar porcentajes a toda España.
Es una foto de un sector y un día, hecha con reglas públicas antes de conocer el resultado.
Si te interesa cómo rastrean las máquinas
Tres artículos de la casa sobre rastreo: