A finales de junio de 2026 empecé a construir un prompt tracker con n8n y PostgreSQL. Quería comprobar cómo aparecían las marcas en las respuestas de las IA, conservar esas respuestas y seguir su evolución.
El sistema fue creciendo con las pruebas: primero, una matriz con los resultados de cuatro motores; después, un ticker con histórico, banda y tendencia; más adelante, los AI Overviews de Google. También incorporé generación y revisión de preguntas, controles de ejecución y contabilidad.
Cuando lo aparqué a finales de agosto, el observatorio llevaba dos meses de desarrollo y mediciones. Faltaba un dashboard con el que completar su salida comercial.
Esta es la historia de cómo llegué hasta ahí.
| El recorrido, en datos del registro |
|---|
| 26 de junio: creé el flujo principal. El 27 se guardó la primera medición que conserva la base de datos. |
| Desde el día cero los cuatro motores respondieron: 36 respuestas de cada uno el 27 de junio. |
| 27 y 28 de junio: el informe ya separaba recomendación y mención, y mostraba las fuentes al lado. |
| Las capturas muestran la evolución del informe entre el 28 de junio y el 24 de julio. |
| Durante el desarrollo repetía ejecuciones en un mismo día para comprobar las respuestas y los cambios del sistema. |
| 6 de julio: el informe ya incluía un ticker. El del 24 de julio mostraba presencia de la marca en tres de las cuatro consultas. |
| 15 de julio: primer registro de AI Overviews. |
| Histórico total: 70 mediciones de 13 sitios. |
Finales de junio: las primeras mediciones
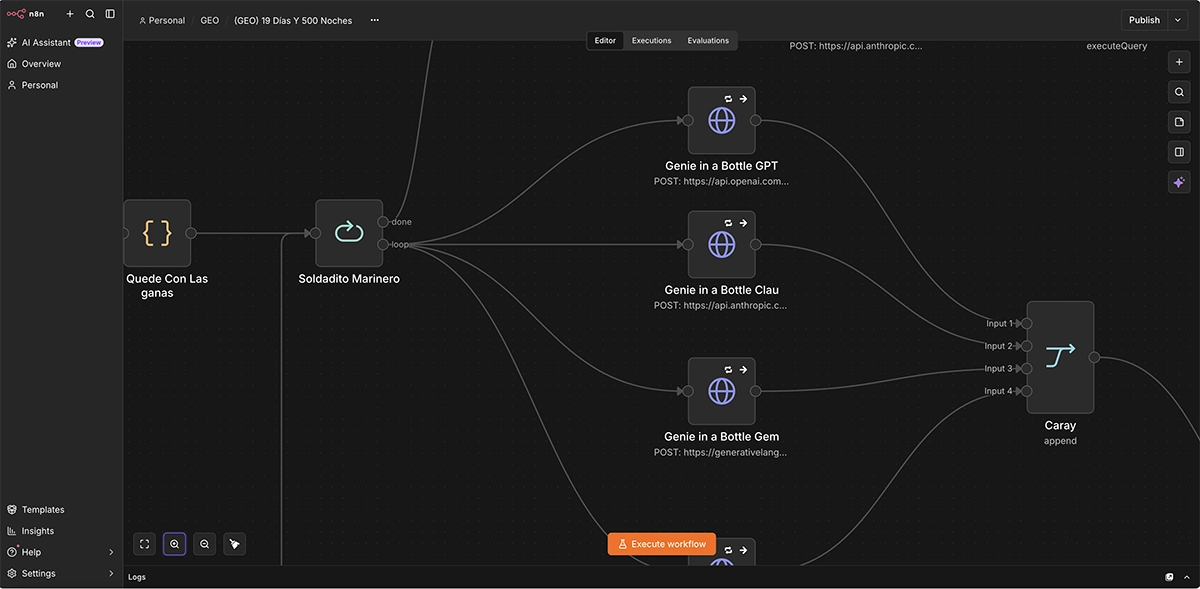
El flujo principal, «19 Días Y 500 Noches», nació el 26 de junio. Las primeras mediciones que conserva la base de datos son del día siguiente.
Para preservar la identidad del negocio, contaré el caso usando una web de conservas de anchoas como ejemplo.
Las capturas muestran los resultados originales con los datos identificativos ocultos. El panel tenía cuatro preguntas y cada una se enviaba a ChatGPT, Perplexity, Gemini y Claude.
El correo del 28 de junio ya mostraba las preguntas en las filas y los cuatro motores en las columnas.
Una leyenda distinguía recomendación, mención, presencia como fuente, ausencia de cita y falta de respuesta. A un lado aparecían los dominios que los motores utilizaban como fuentes.
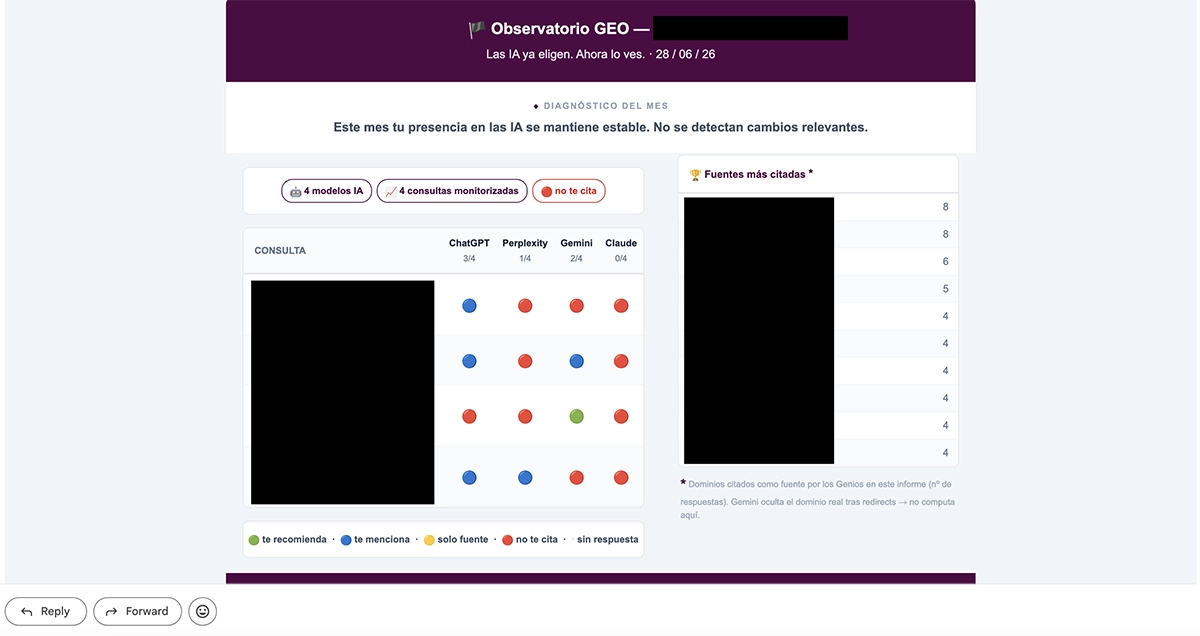
Era la primera versión del informe. Con las pruebas fui afinando tanto la presentación como la forma de explicar los resultados.
Lo que apareció al repetir: de la matriz al ticker
Las pruebas y la evolución del informe se extendieron durante varias semanas.
Las capturas que acompañan este relato están fechadas el 28 de junio, el 6 de julio y el 24 de julio. El seguimiento tuvo intervalos entre jornadas y varias ejecuciones en un mismo día.
Los resultados se movían: una marca podía aparecer en una pregunta y desaparecer al repetirla. Cambiaban las fuentes y la forma en que cada motor la presentaba.
El informe tenía que ayudar a interpretar esas oscilaciones.
De ahí nació el ticker: una lectura del histórico con tres capas.
- Postura: cómo aparecía la marca en las consultas observadas.
- Tendencia: cómo evolucionaban los resultados dentro de la ventana utilizada.
- Banda: entre qué valores se había movido la medición.
La media y un pequeño gráfico acompañaban esa lectura. El resultado de una ejecución quedaba situado dentro de su histórico.
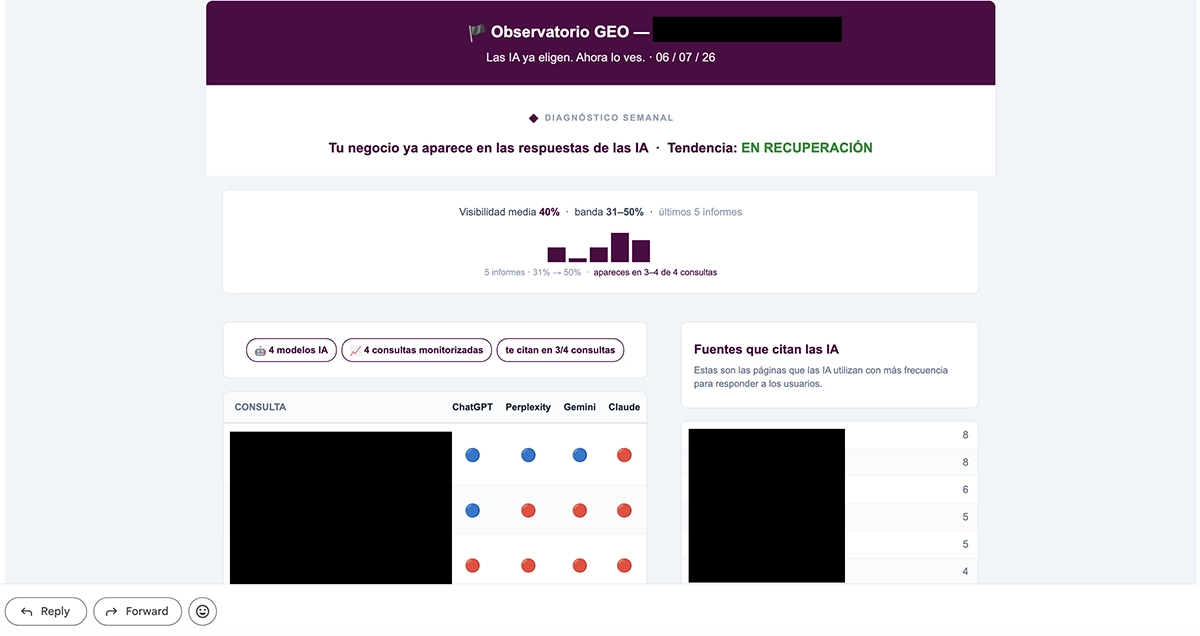
El ticker ya estaba presente en el informe del 6 de julio, con una visibilidad media del 40 % y una tendencia en recuperación.
En el del 24 de julio, la media era del 42 %, la banda seguía en el 31–50 % y la tendencia figuraba como estable. En la matriz de aquella ejecución, la marca aparecía en tres de las cuatro consultas.
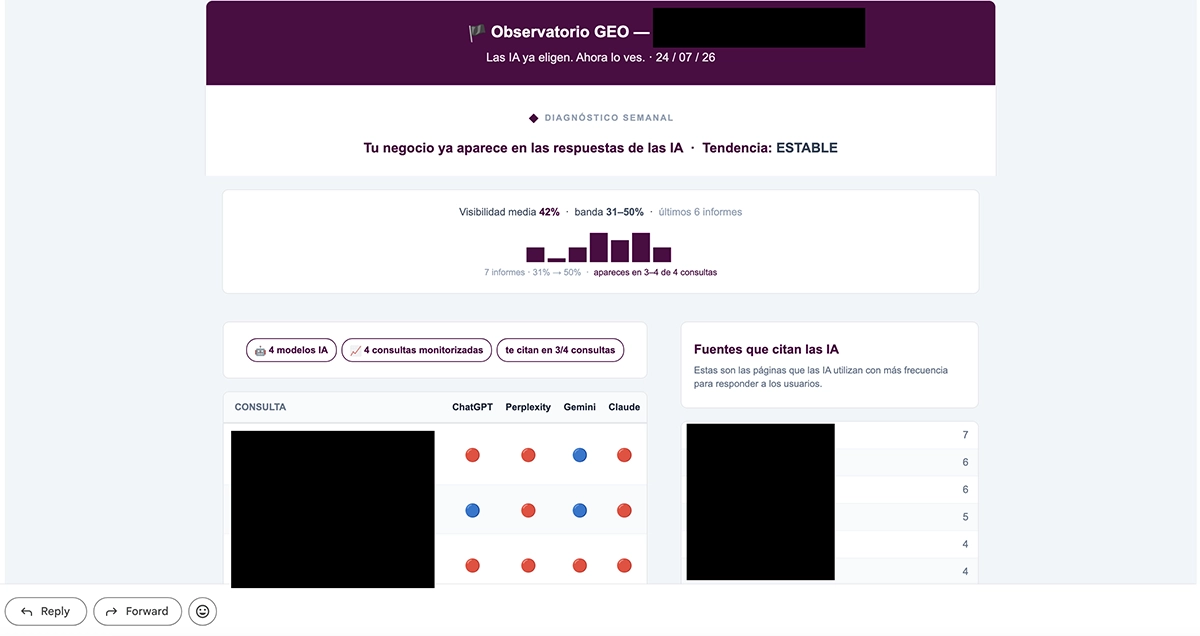
Son dos medidas con denominadores distintos.
La presencia en tres de cuatro consultas indica en cuántas preguntas aparecía la marca en algún motor. La media del ticker resume la cobertura de las combinaciones de pregunta y motor en su ventana histórica.
Durante el desarrollo corregí también cómo se construía esa ventana.
Las ejecuciones repetidas el mismo día inflaban el número de observaciones. Ajusté el cálculo para quedarme solo con la última medición de cada día y evitar que las pruebas de desarrollo aparentaran semanas de seguimiento.
El ticker se calculaba con los resultados ya almacenados. Releerlos y recomponer el informe permitía seguir afinando la presentación sin consumir nuevas llamadas a los modelos.
Qué medía el observatorio
Separaba la presencia de la marca en el texto y la presencia de su dominio entre las fuentes. Dentro del texto, el clasificador distinguía una recomendación de una mención.
Esa separación permitía ver situaciones diferentes: una IA podía mencionar un negocio y utilizar páginas ajenas como fuentes; también podía enlazar su dominio sin recomendarlo expresamente.
La medición describía las respuestas obtenidas con unas preguntas, unos motores y una configuración concretos.
Las APIs eran el canal observado.
Una conversación en las aplicaciones de consumo podía incorporar otro contexto, memoria o comportamiento de búsqueda.
El histórico conservado reúne 70 mediciones de 13 sitios. Es el registro disponible del recorrido, con sus distintas etapas y paneles; los resultados de sitios o configuraciones diferentes se analizan por separado.
Antes de medir: elegir y revisar las preguntas
Las preguntas también tenían su cadena de producción. Rompecintura, otro flujo en n8n, leía una página de la web, la dirección dada de alta, y utilizaba GPT-4o mini para proponer cuatro preguntas de tipo:
- Transaccional
- Comparativa
- Nicho
- Autoridad
El encargo era escribir como una persona que busca ese servicio sin conocer la marca.
El generador recibía el texto de esa página y la marca como contexto, pero tenía prohibido nombrarlas en las preguntas. Esa instrucción necesitaba una comprobación posterior.
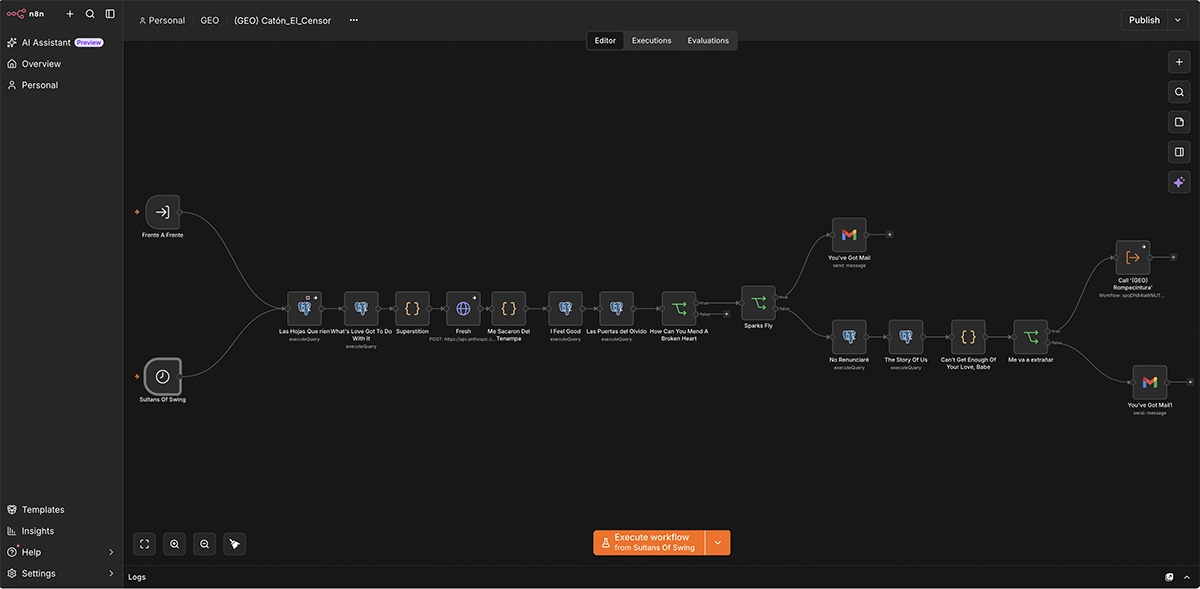
Ahí entraba Catón el Censor, otro flujo, bautizado así en honor del político romano recordado por la severidad con que ejerció de censor.
Primero, Rompecintura comprobaba la cobertura de intenciones y buscaba menciones explícitas de la marca, el dominio o sus variantes.
Después, Catón, usando un modelo Opus de Claude, revisaba el conjunto:
- Naturalidad
- Intención comercial
- Adecuación geográfica para negocios locales
Un veto del código prevalecía aunque el modelo aprobara las preguntas.
El circuito podía retirar el lote rechazado y devolver a Rompecintura los motivos de la censura para generar otro. Admitía hasta dos regeneraciones; si volvía a rechazar el lote, se detenía y me avisaba por correo.
El observatorio seleccionaba las preguntas activas y aprobadas.
Preparar y revisar el panel con ese circuito también consumía llamadas, aunque no fuera un trabajo que hubiera que repetir en cada pase.
Julio: se incorporan los AI Overviews
Los AI Overviews llegaron después de las primeras pruebas con los cuatro motores. El primer registro que se conserva de esa rama es del 15 de julio.
De esa parte se encargaba un flujo llamado «En La Fiesta De Blas». Leía las preguntas activas y aprobadas del sitio y las consultaba mediante DataForSEO, con la búsqueda configurada en español, para España y en escritorio.
Blas comprobaba si Google había mostrado un AI Overview.
Cuando lo encontraba, recogía su texto y sus referencias, comprobaba si el dominio del sitio figuraba entre las fuentes y guardaba el resultado en PostgreSQL, junto con el coste devuelto por el proveedor.
En ese registro distinguía tres situaciones:
- Consulta fallida
- Búsqueda válida sin AI Overview
- Búsqueda con AI Overview
Después, el clasificador con Claude evaluaba también si el texto del resumen mencionaba la marca.
Consultar Gemini por API y observar los AI Overviews eran dos mediciones distintas.
Cómo creció el tracker: los 16 flujos
Al revisar el tracker completo, el inventario reúne 16 flujos de n8n con el prefijo GEO: 11 flujos para las preguntas, la medición y el control del tracker, y otros cinco para acceso y operabilidad web.
Esos 16 flujos de n8n no se ejecutan todos en cada pase.
Hay formularios de entrada, tareas programadas, subflujos y herramientas auxiliares. El trabajo también incluye mantener las conexiones entre esas piezas, sus datos y sus salidas.
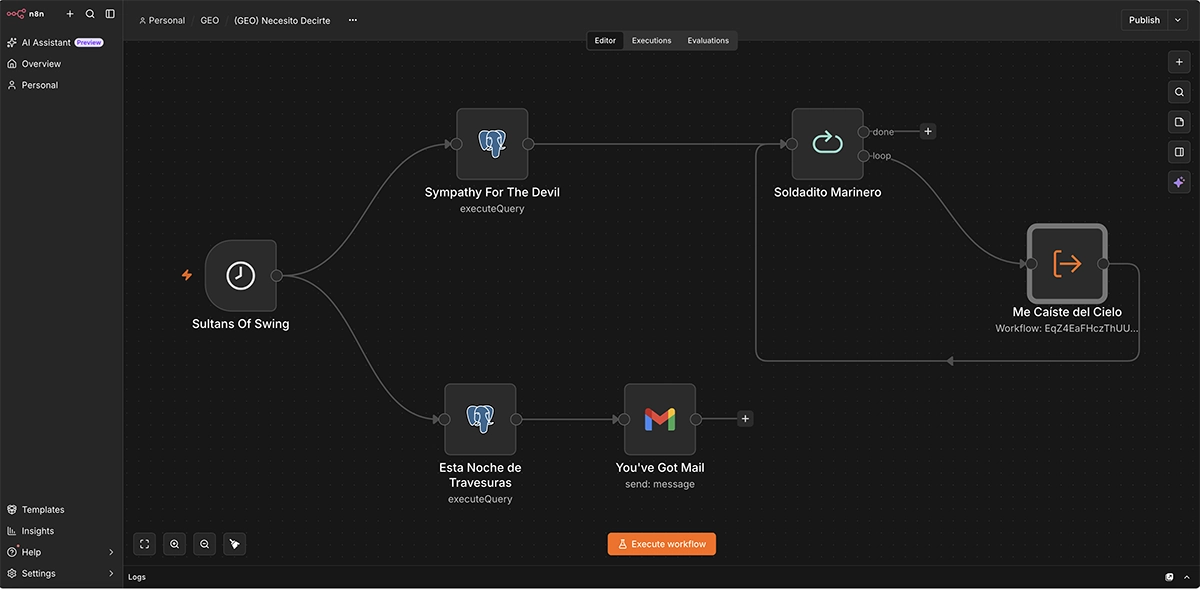
Los 11 flujos de medición y control del tracker
| Flujo | Trabajo que resuelve |
|---|---|
| Rompecintura | Lee una página de la web del negocio y genera un lote de preguntas con GPT-4o mini. También recibe los motivos de censura para preparar otro lote. |
| Catón el Censor | Audita las preguntas con reglas de código y Claude Opus; registra el veredicto y gestiona el rechazo y la regeneración. |
| Y Tú Te Vas | Gestiona el alta exprés: comprueba el sitio y las preguntas disponibles, y coordina generación, censura y medición cuando corresponde. |
| Mi Historia Entre Tus Dedos (EJECUTOR) | Ofrece un mando mediante formulario para activar o desactivar sitios y lanzar una medición. |
| Necesito Decirte | Despacha las mediciones programadas de los sitios con preguntas aprobadas y avisa de los que se quedan sin ellas. |
| 19 Días Y 500 Noches | Consulta los cuatro motores, normaliza sus respuestas, clasifica menciones, conserva resultados y prepara el informe. |
| En La Fiesta De Blas | Recoge los AI Overviews de Google mediante DataForSEO, sus fuentes y el coste de las consultas. |
| Un Giro Teatral | Registra el consumo remitido por el observatorio: llamadas, tokens y búsquedas, asociado a la ejecución y al modelo. |
| A Thousand Miles | Sondea los dominios que aparecen como fuentes y mantiene su registro de salud. |
| Persiana Americana | Clasificador auxiliar de fuentes: normaliza y distingue marcas, plataformas y directorios, teniendo en cuenta la salud del dominio. |
| Héroe de Leyenda | Atiende la consulta desde la interfaz web: recupera resultados o coordina el alta y la medición según el estado del sitio. |
Los otros cinco: acceso y operabilidad
Estas piezas completan el sistema GEO que construí alrededor del observatorio.
Responden a otras preguntas: si los bots pueden acceder al sitio y qué capacidades ofrece la web para que un agente opere en ella. Tienen su propio recorrido; no son cinco motores adicionales de citación.
| Flujo | Trabajo que resuelve |
|---|---|
| Como Quien Pierde Una Estrella | Comprueba robots.txt, el contenido HTML disponible y las respuestas del servidor ante distintos identificadores de bots. |
| Recuérdame Bonito | Coordina las comprobaciones periódicas de acceso para los sitios activos. |
| Brothers In Arms | Recibe solicitudes de diagnóstico, valida sus datos y límites, llama al análisis de acceso y conecta con la cola de operabilidad. |
| Gata Fiera | Encola los sitios para el análisis de operabilidad que procesa el sistema externo a n8n. |
| Harto | Compone y envía el informe conjunto de acceso y operabilidad, incluida su versión en PDF. |
Llegados a este punto, es justo reconocer que la música es una de mis grandes pasiones y que no me caso con ningún género.
Puedo pasar sin transición de escuchar a Hendrix y Black Sabbath a Tego Calderón y Daddy Yankee, seguido de Cornelio Reyna y Antonio Aguilar, según mi estado de ánimo.
Por eso nombré tanto los flujos como los nodos con canciones que me gustan muchísimo.
La infraestructura común
La arquitectura combinaba cuatro piezas:
| Pieza | Función |
|---|---|
| n8n | Coordinar preguntas, llamadas y generación del informe |
| PostgreSQL | Conservar preguntas, ejecuciones, resultados y fuentes |
| APIs de los cuatro motores | Producir las respuestas analizadas |
| DataForSEO | Recoger los AI Overviews de Google y sus fuentes para las preguntas del panel |
El procesamiento separaba las señales de marca y dominio, consolidaba los resultados y componía un correo.
Claude intervenía en tres papeles distintos.
Era uno de los motores cuyas respuestas observaba; con Opus revisaba las preguntas en Catón; y con Haiku clasificaba las menciones y su sentimiento en las respuestas, además de evaluar la presencia de la marca en el texto de los AI Overviews.
Eran tareas y llamadas diferentes, aunque compartieran proveedor.
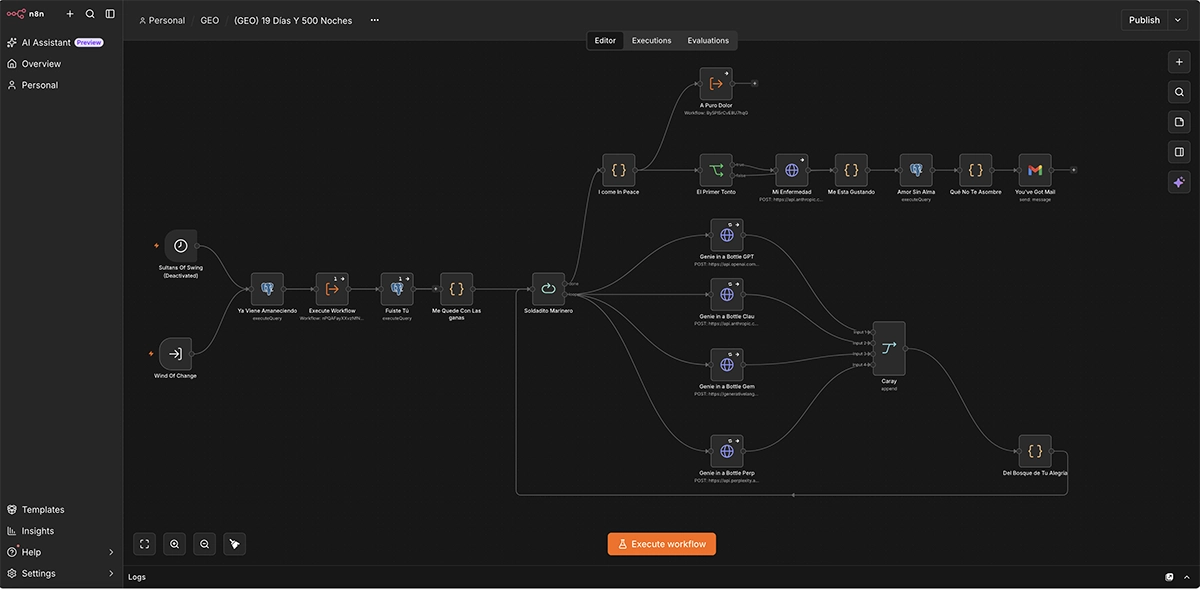
Los problemas que fui resolviendo
Las pruebas sacaron a la luz fallos en la ejecución, en la cobertura y en la contabilidad.
En una primera versión, la convergencia de las ramas de varios motores provocó ejecuciones duplicadas y varios correos.
Corregí cómo se reunían las respuestas para que el bucle continuara una sola vez y el informe saliera al terminar la tanda.
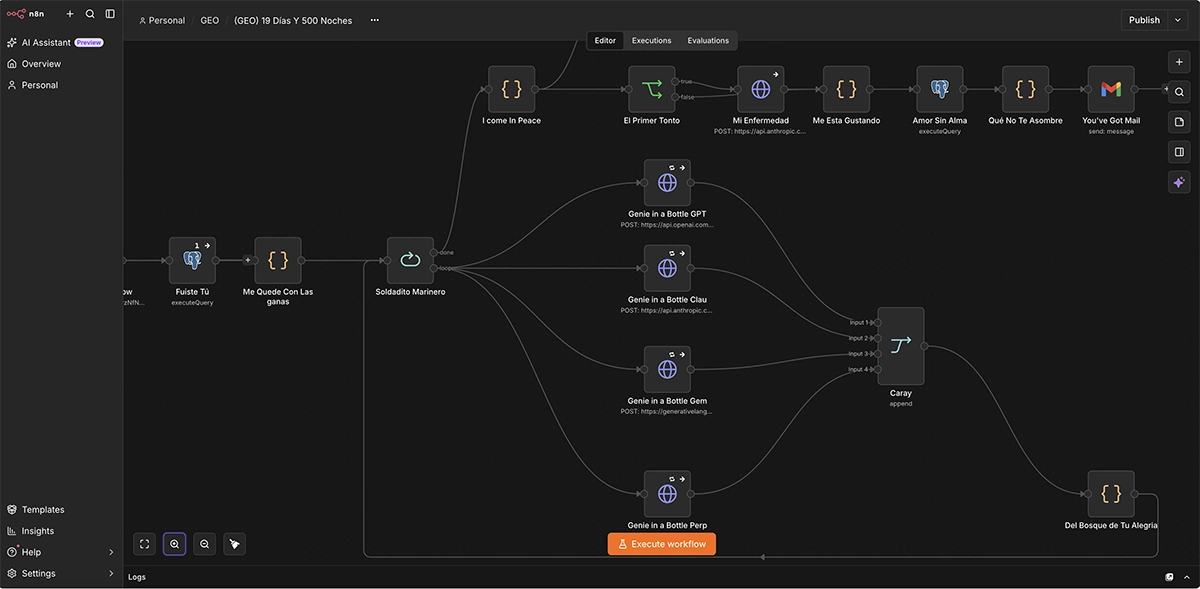
En una etapa posterior falló el nodo de ChatGPT, que estaba configurado para continuar ante un error.
El proceso terminó y el informe se envió con respuestas de tres motores. Incorporé un control para declarar cuántos habían aportado datos válidos y cambié el modelo utilizado.
Una respuesta que no llega tiene que quedar identificada como fallo de cobertura. Contarla como ausencia de la marca falsearía la lectura.
La contabilidad tenía otro punto ciego: recogía el consumo de los cuatro motores, pero dejaba fuera las llamadas del clasificador y de Catón.
Además, faltaban tarifas por petición y búsqueda. En una prueba, Perplexity figuraba sin coste porque no había incorporado su tarifa.
Por eso contrastaba lo registrado por la automatización con la facturación del proveedor. Un cero en el contador podía significar una partida sin contabilizar.
Hay que entender que, a la par del tracker, tenía y tengo que atender otras obligaciones; lo digo a modo de disculpa por los errores cometidos.
Agosto: un nuevo panel en un sistema que ya tenía recorrido
DummySEO también pasó por distintos paneles. Las preguntas iniciales giraban alrededor del marketing digital en Almansa. Más adelante decidí estudiar servicios de consentimiento y analítica en España.
Preparé a mano un lote de seis preguntas y lo di por aprobado sin pasarlo por Catón. Cubría contratación, comparación, especialización en una configuración concreta, autoridad, resolución de problemas e implementación técnica.
Rompecintura producía las cuatro intenciones fijas de su circuito; este lote tenía otro origen.
Una pregunta planteaba dónde contratar la implantación de Consent Mode. Otra describía un problema de Google Analytics después de instalar un banner de cookies.
Ese cambio de ámbito exigía separar la nueva serie de la anterior.
En la medición del 22 de agosto, los tres motores que aportaron respuestas no registraron citaciones de DummySEO para esas preguntas; ChatGPT había fallado.
En la rama de Google aparecieron AI Overviews en cuatro de las seis consultas, sin presencia de DummySEO en el texto ni entre las fuentes.
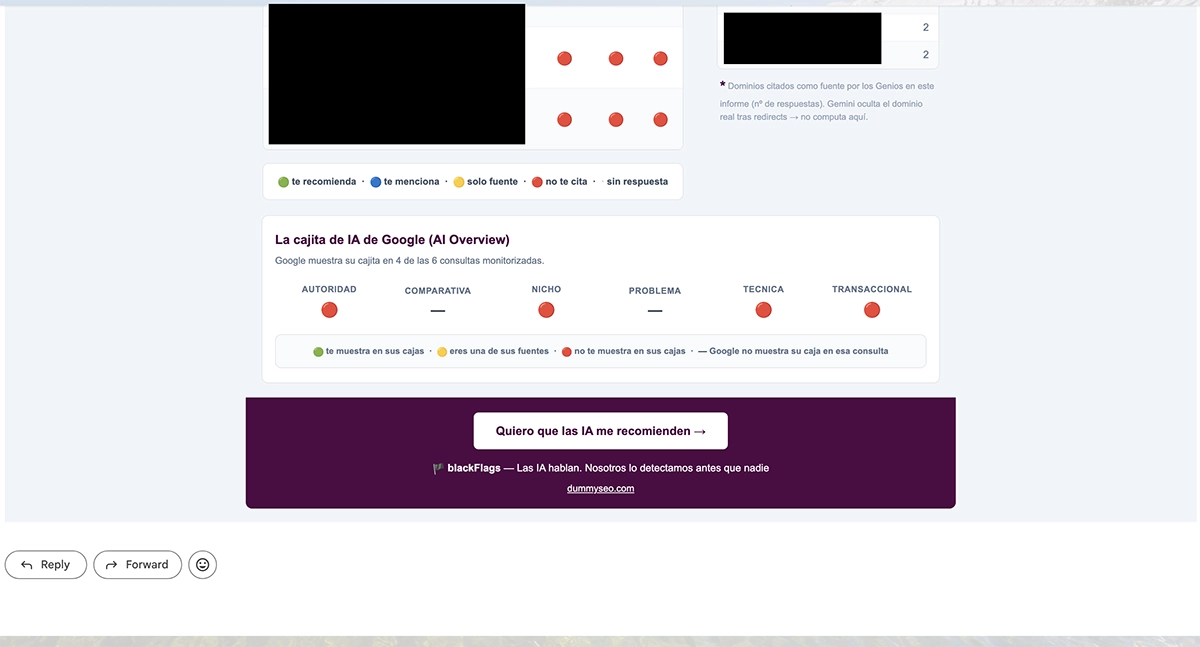
La medición del 26 de agosto repitió ese panel con los cuatro motores operativos: 24 respuestas sin citaciones de DummySEO. Los AI Overviews aparecieron de nuevo en cuatro consultas, sin presencia de la marca.
Estos resultados pertenecen al panel final de DummySEO.
Para entonces, el observatorio ya había pasado por las pruebas de junio y julio, por otros sitios y por la evolución del informe hasta el ticker.
Cuánto costaba obtener nuevas mediciones
El consumo era una parte de la operación que también necesitaba conocer.
Entre el 27 de junio y el 1 de agosto, la factura de Anthropic ascendió a 48,68 dólares. En ese periodo, el observatorio registró 255 llamadas a Claude como motor consultado.
La factura y ese recuento tenían distinto alcance: no disponía de un desglose completo del importe entre el motor, Catón y el clasificador.
A ello se sumaban otros proveedores, la infraestructura y el trabajo de desarrollo y mantenimiento.
La medición de DummySEO del 22 de agosto sirve como ejemplo de aquella contabilidad:
| Concepto | Importe o consumo | Alcance |
|---|---|---|
| Presupuesto previo del pase | Aproximadamente 0,85 USD | Estimación anterior a la ejecución. |
| Cálculo posterior del pase | Aproximadamente 1,25 USD | Cálculo con partidas estimadas y sin la participación de ChatGPT. |
| Claude como motor consultado | 1,1709 USD | Seis llamadas y doce búsquedas; excluye Catón y el clasificador Haiku. |
| DataForSEO | 0,02 USD | Seis consultas para comprobar los AI Overviews. |
El cálculo posterior superaba el presupuesto en casi la mitad y seguía siendo incompleto.
De aquella prueba salió una proyección de unos 9,3 euros mensuales a dos pases semanales, bajo los supuestos utilizados entonces. Son importes históricos del tracker, no tarifas actuales ni una mensualidad completa pagada.
Para planificar nuevas mediciones, seis preguntas por cuatro motores suponen 24 llamadas en una ronda. Dos rondas semanales durante cuatro semanas suman 192. Si cada pregunta se repite tres veces por ronda, son 576.
Aparte van DataForSEO, las búsquedas, los reintentos y la clasificación. La generación y la revisión de preguntas añaden consumo cuando se prepara o cambia el panel.
Repetir varias veces en un intervalo corto ayuda a observar la variabilidad bajo condiciones próximas.
Repetir a lo largo de las semanas permite seguir la evolución, durante la que también pueden cambiar los modelos y las fuentes. Cada propósito necesita su propia planificación.
Construirlo también significa mantenerlo
Tener el tracker en casa me permitía inspeccionar las preguntas, las respuestas y los fallos. También me hacía responsable de mantener las integraciones, las tarifas y los informes.
Para compararlo con un servicio comercial habría que sumar consumo, infraestructura, desarrollo, mantenimiento y análisis.
Una suscripción puede cubrir parte de ese trabajo; hay que comprobar su alcance antes de comparar importes.
No registré una valoración completa de las horas de trabajo que invertí. La factura de las APIs, por sí sola, no permite calcular el ahorro total frente a una herramienta comercial.
Por qué lo aparqué
A finales de agosto, el observatorio ya había recorrido las pruebas con varios sitios, la construcción del ticker y la incorporación de los AI Overviews. Los informes llegaban por correo y el histórico quedaba guardado.
Lo aparqué a la espera de construir un dashboard: un panel en el que quien contrate el servicio pueda consultar y explorar sus resultados, más allá del correo.
El coste de cada medición era una variable que había que gestionar; sin embargo, lo que decidió la pausa fue un motivo de mayor trascendencia.
En paralelo estaba construyendo otra automatización, la que conté en la trilogía de Screaming Frog headless.
Dos sistemas a medio hacer no avanzan igual que uno terminado, así que decidí dónde poner mi tiempo: primero cerrar esa y después retomar el observatorio con su dashboard.
Las mediciones están en hibernación. Sigue programada una sonda que comprueba si responden los dominios citados como fuente, sin llamadas a modelos.
Me quedó un sistema construido y una experiencia que abarca desde los primeros informes de finales de junio hasta un observatorio con histórico, ticker, revisión de preguntas y controles de cobertura. La siguiente etapa empieza por ese dashboard.
Lectura relacionada: el artículo de Cristina Simón sobre su prompt tracker, que sirvió como referencia tanto para estructurar el relato de esta experiencia como para documentar la creación de mi propio tracker.